
 Diseño Editorial Social
en Portales de Información
utilizando Técnicas de
Minería de Datos
Clustering Online
|
El principal desafío del proyecto corresponde a
la segmentación en línea de los artículos que
permanentemente llegan al sistema. Algunos
tópicos sobreviven, otros pasan de moda, o
surgen temas nuevos, tendencias.
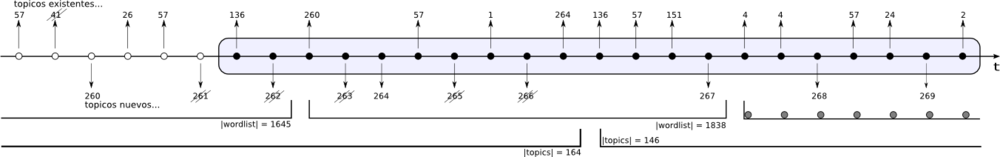
Existen diversos enfoques para abordar el problema del clustering incremental: algoritmos basados en representación jerárquica (COBWEB, incr-DBSCAN), o algoritmos basados en una representación plana de los clusters (Single-Pass, KNN). La solución elegida se basó en el algoritmo de Single-Pass: para cada nuevo vector se calcula su distancia a cada uno de los centroides de los grupos existentes y se elige el cluster más cercano. Si la similaridad es mayor a un cierto umbral, se asigna a éste. En caso contrario, se forma un nuevo cluster. Existen diversos problemas derivados de la agregación incremental de artículos: - actualización y crecimiento de la lista de palabras. - envejecimiento de los artículos... y de los tópicos. - formación de tópicos basura.
La implementación realizada busca resolver estos
problemas, mediante el uso de ventanas o buffers.
Ahora es posible realizar operaciones básicas de
mantención:
|
|