
 Diseño Editorial Social
en Portales de Información
utilizando Técnicas de
Minería de Datos
Clustering Batch
El espacio vectorial creado debe ahora ser
segmentado, permitiendo la agrupación de
artículos según su grado de similaridad. La
similaridad entre documentos se mide
considerando la distancia coseno, definida
como:
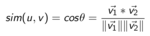 Vectores (artículos) que comparten muchas coordenadas (palabras) tendrán valores cercanos a 1 (alta similaridad). Vectores ortogonales (no tienen términos en común) tendrán similaridad 0. El algoritmo de particionamiento utilizado corresponde a la optimización de una función objetivo, que busca medir la similaridad interna del conjunto de grupos formados. Las principales alternativas son: 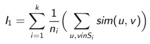 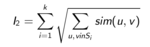 Ambas funciones permiten realizar la segmentación exitosamente, presentando distintos comportamientos en la forma de distribuir los clusters. No existe un claro dominio de una función sobre la otra.
Un problema importante de esta fase es la
determinación del número de clusters a formar.
Esto determina la granularidad de los tópicos
y es uno de los factores fundamentales en la
calidad de los resultados. Los experimentos
realizados recomiendan utilizar un valor entre el
10% al 20% del total de documentos procesados.
 |
|